・ AI / 個人開発 / 自動化 / GitHub Actions

AI情報を毎朝5件だけ届くリサーチbotを作った話
この記事について 📖
対象読者: 情報収集に時間を取られている方、Claude Code を自動実行に組み込みたい方、LINE を通知先として使いたい方
この記事で扱うこと: 毎朝 7:20 に「昨日の技術ニュースから 5 件だけ」を LINE へ届ける仕組みを、なぜ作ったか・どう設計したか・400 件をどうやって 5 件まで絞り込むかまで通して解説いたします。
はじめに 👋
こんにちは!H×H のセンリツ大好きエンジニアです!✌️
技術情報を追いかける作業は、毎日一定の時間を確実に消費します。しかもその消費は今日限りではなく、明日も明後日も同じだけ発生し続けるという性質を持っています。
そこで、情報を「探す」作業そのものを手元から外すことにしました。深夜のうちに 16 の情報源を巡回し、集まった候補から既に見たものを取り除き、残ったものを 5 件だけカードにして LINE へ送る。朝やることは、届いたカードを眺めて選ぶことだけです。
この記事では、その構築過程で下した設計判断と、実際に踏んだ落とし穴を共有いたします。着想は、AI 関連の RSS を追っているなかで見かけた「情報源そのものを AI に見張らせる」という考え方でした。
この記事はおよそ 7100 字なので、14 分で読めます!
※この記事は AI と 2 人 3 脚で執筆されています
目次 📚
- 届くもの — まず完成形から
- 全体構成 — 4 つのレイヤー
- 実行基盤に GitHub Actions を選んだ理由
- 情報源の設計 — 取り口は死ぬ前提で組む
- 記事の抽出方法 — 400 件を 5 件にする
- 届け方 — Flex Message と HTML レポート
- 踏んだ落とし穴
- コスト構造
- まとめ
1. 届くもの — まず完成形から 📬
「朝 5 分で『今日どれを見るか』を決めるための道具であり、読み物ではありません」
毎朝 7:20(JST)、LINE にカルーセル形式のカードが 5 枚届きます。各カードには次の情報だけが載っています。
- トピック ID とカテゴリ
- タイトル
- 読者にとっての意味を示す一文
- 出典を開くボタン
最後の 6 枚目のカードから、その日のレポート全文を HTML で開けます。全文には採用した 5 件の詳細に加えて、見送った候補とその理由まで載せました。
「なぜこのネタが出てこなかったのか」を後から検証できること。これがこの種の自動化では効いてきました。
実際に届くカードの見た目や、より詳しい仕組みは Research Desk の紹介ページにまとめてあります。
2. 全体構成 — 4 つのレイヤー 🏗️
「収集・選別・生成・配信を明確に分離しています」
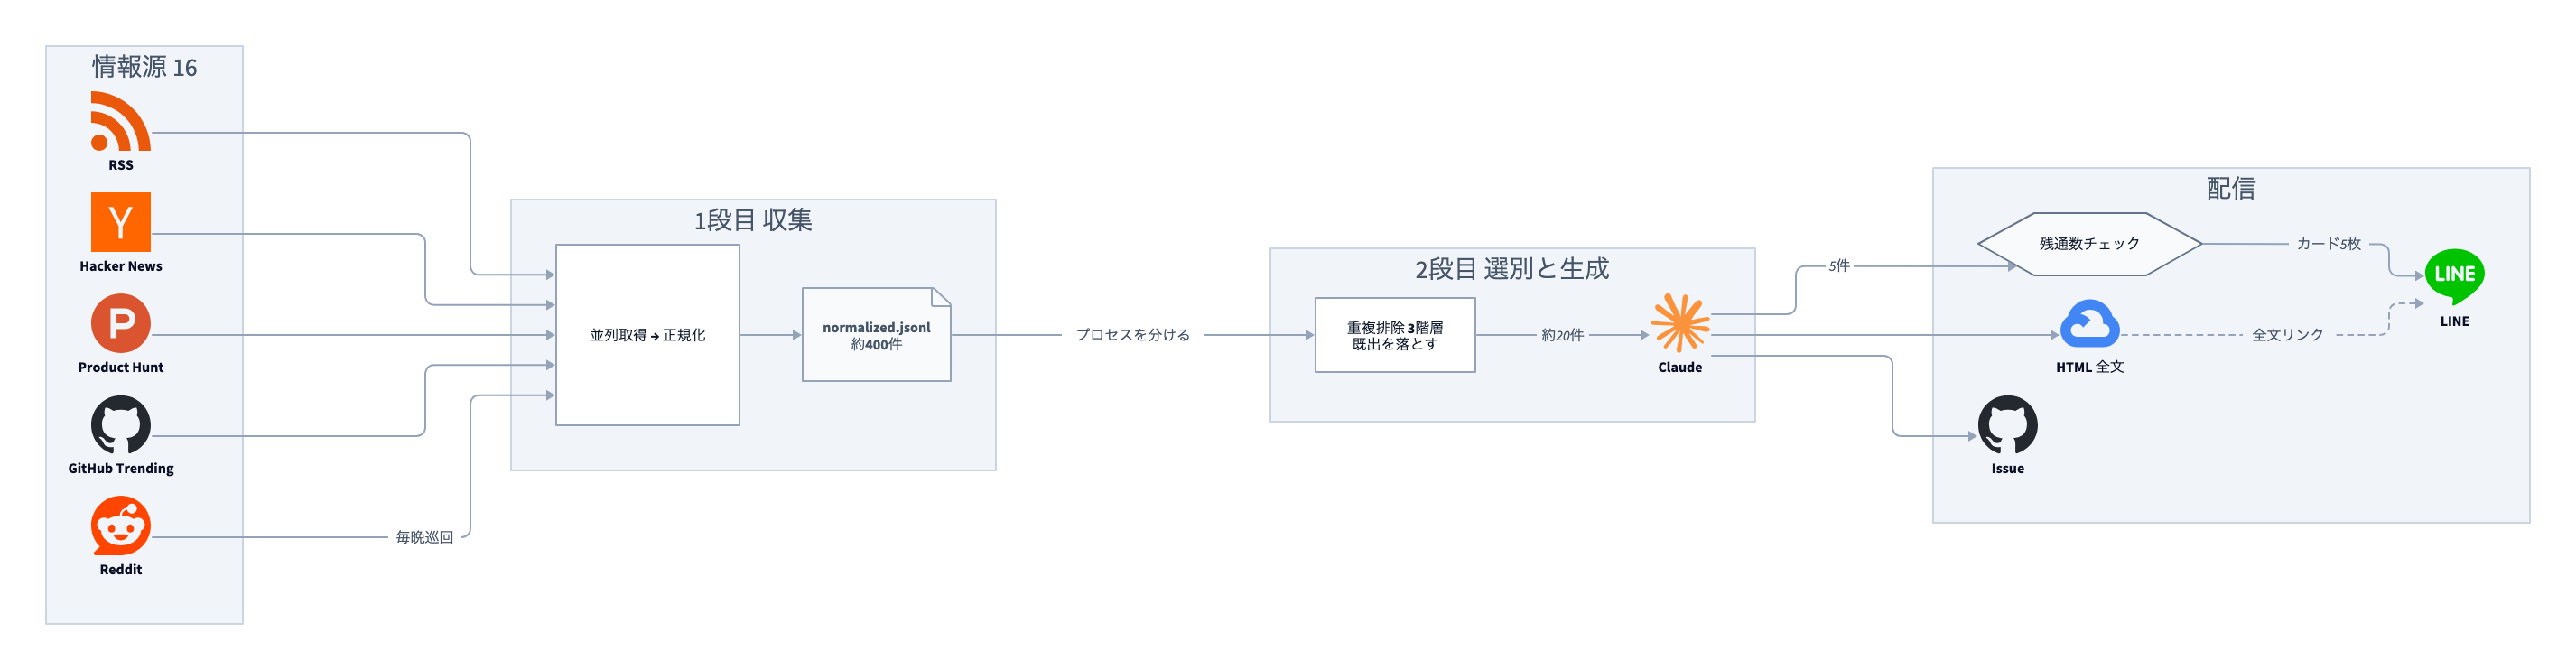
構成は次の 4 層です。
- 収集層 — 並列取得と正規化
- 選別層 — フィルタと 3 階層の重複排除
- 生成層 — カテゴリ別の並列分析と統合
- 配信層 — LINE カード / HTML 全文 / GitHub Issue
重要なのは、収集層と選別層以降を別プロセスに分けている点です。当初は 1 つのエージェントに収集から生成まで通させていましたが、これは後述する理由で機能しませんでした。
設定はすべてリポジトリ内の YAML に置いています。巡回先を定義する sources.yml と、取捨選択の基準を定義する profile.yml の 2 つです。
前者は差し替えが利きます。しかし後者を空欄のまま運用すると、出力は誰の役にも立たないニュース一覧になります。
profile.yml の構造(抜粋)
# 合計10。レポートの構成比と候補のスコア重みに直結する
genre:
  ai: 4
  dev_tools: 3
  indie_product: 2
  business_tech: 1

not_interested:
  - 一般ニュース(政治・事件・スポーツ・芸能)
  - プレスリリースの焼き直し、製品の宣伝記事
  # ... 他2件

tone:
  must_not:
    - 出典のない断定
    - 煽り(「もう遅い」「知らないとヤバい」)
  # ... must 側には「事実と推測を分ける」などを列挙
情報収集の自動化で最も重要なのは、巡回先ではなく「取捨選択の基準」の明文化です。
どの情報源を見るかは、あとからいくらでも足せます。一方で「何を残し、何を捨てるか」を決めていなければ、集めた 400 件はそのまま 400 件として出てきます。
3. 実行基盤に GitHub Actions を選んだ理由 ⚙️
「毎朝確実に走ること、それだけが要件でした」
候補は 4 つありました。
| 手段 | PC が起動していなくても走るか | 判断 |
|---|---|---|
| Claude Code 内蔵の cron | いいえ | 不採用 |
| launchd(macOS) | 起床時に遅れて実行 | 不採用 |
| ローカルの n8n(Docker) | いいえ | 不採用 |
| GitHub Actions | はい | 採用 |
決め手は 3 点です。
prompt入力を渡すと automation mode になり、メンションなしで任意のイベントから無人実行できる(公式ドキュメントに「Run on a schedule」の節が用意されています)- サブスクリプション認証のトークンを使うと、API 課金ではなく既存のサブスクリプションが消費される
promptにスキル呼び出しを書けるため、手順の定義をリポジトリ側に持てる
3 番目が特に効きました。ワークフローは起動するだけで、実際の手順はリポジトリ内の Markdown に書いてあります。設計を変えたいときにワークフローを触る必要がありません。
cron の指定には注意点があります。GitHub は「schedule イベントは高負荷時に遅延する。高負荷時間帯には毎時の開始が含まれる」と明記しています。そのため毎時 00 分を避けて 20 分に設定しました。それでも実測では 20 分ほど遅れて発火しています。分刻みの正確さが要る用途には向きません。
4. 情報源の設計 — 取り口は死ぬ前提で組む 🌐
「16 のうち何本かは、必ずどこかで死にます」
巡回先は 7 グループ 16 ソースです。海外テックメディアの RSS、Hacker News、Product Hunt、GitHub Trending、Reddit、中国のトレンド、そして検索トレンド。
設計時に効いたのは、すべての URL を実際に叩いてから設定ファイルに書いたことです。この確認だけで、公式 RSS が存在しないメディアが複数見つかりました。
- RSS 提供を終了し
/feedが HTML を返すメディア - 公式 RSS が存在しない省庁サイト
- 公式 API も RSS も持たない GitHub Trending
さらに Reddit では、板ごとに個別アクセスすると 429(レート制限)で落ちることが判明しました。これは multireddit 形式で 6 板を 1 リクエストにまとめることで解決しています。
sources.yml での定義例(Reddit の項)
reddit:
  - id: reddit_multi
    # 6板を "+" でつないで1リクエストにまとめる
    url: "https://www.reddit.com/r/LocalLLaMA+artificial+SaaS+Entrepreneur
           +ProductManagement+SideProject/top.rss?t=day"
    status: ua_required
    note: |
      板ごとに個別アクセスすると 429 で落ちる(実測)。分割しないこと。
そのうえで、収集手順には次のフォールバック方針を明示しています。
- 指定回数まで再試行
- ニュース検索の
site:指定で代替の取り口を探す - 粘らずスキップし、「取れなかった情報源」として記録
3 番目が重要です。実際、運用開始後に外部の集約 API が 3 つ同時に 404 を返すようになりました。
この方針のおかげでレポート自体は止まらず、記録を見て代替経路へ差し替えるだけで復旧しています。
取得できた情報源が半数を切った場合は、分析に進まず「何が死んだか」だけを書いたレポートを残す設計にしています。中身の薄いレポートを出すより、事実を伝えて止まる方が害が小さいためです。
5. 記事の抽出方法 — 400 件を 5 件にする 🔍
「価値があるのは、残したものより捨てたものの方です」
ここがこの仕組みの中核です。1 日に集まる候補は 400 件前後あり、そこから 5 件まで落とします。
5-1. 正規化 — 生データをそのまま読ませない
取得した XML や JSON は、そのままエージェントのコンテキストに入れません。スクリプトでパースし、必要なフィールドだけを 1 件 1 行の JSONL に落とします。
{
  "source": "techcrunch",
  "title": "...",
  "url": "https://...",
  "published": "2026-08-20T04:12:00Z",
  "summary": "最大200字まで"
}
要約は 200 字で切り、この段階で lookback_hours(既定 30 時間)より古いものも捨てます。
24 時間ではなく 30 時間にした理由は、前日分の取りこぼしを拾うためでした。
5-2. 重複排除 — 3 階層で落とす
ここを雑にやると、3 日目から毎朝同じネタが並びます。
L1: 同一 URL の再取得
URL を正規化してから既出リストと突合します。正規化の内容は、スキームの統一、ホスト名の小文字化、先頭 www. の除去、フラグメントの除去、AMP の剥がし、そしてトラッキングクエリの全削除(utm_* / ref / fbclid / gclid など)です。
このなかで最も効いたのが、ニュース検索経由のリンクをリダイレクト先の実 URL まで解決してから正規化するという処理でした。これを飛ばすと、同じ記事が毎日別の URL として扱われ、重複排除が丸ごと機能しなくなります。実測では 1 日あたり 130 件前後がこの解決を必要としました。
L2: 同一ニュースの配信違い
同じ発表を複数の媒体が報じている場合をまとめます。タイトルを正規化したうえで、文字 3-gram の Jaccard 係数が 0.72 以上なら同一クラスタとみなします。日本語でも形態素解析は不要です。
クラスタの代表には一次ソースを選びます。優先順位は「官公庁・企業の公式発表 > 通信社 > まとめ・ブログ」です。畳んだ分は「他 N 媒体も報道」と付記します。報道された本数そのものが話題性のシグナルなので、捨てずに残します。
L3: 同じネタの再浮上
過去 14 日のレポート掲載分と、投稿まで至った分(90 日)に突合します。ここで重要なのは、既出だからといって即座に除外しないことです。
| 状態 | 扱い |
|---|---|
| 前回から何も動いていない焼き直し | 除外 |
| 数値・日付・対象者・ステータスが変わった | 続報として採用し、前回との差分を明示 |
| 投稿済みで差分なし | 除外(90 日) |
「検討中 → 決定」「金額が確定した」「対象が広がった」は、既出であっても新しい価値があります。実際の運用でも、一度報じた制度の続報が「手続き側の条件が新たに判明した」という理由で採用されました。
実測では、この 3 階層を通すと 203 件のうち 183 件が既出として脱落し、残りは 20 件でした。
5-3. 分析 — カテゴリ別に並列で読ませる
残った候補をカテゴリ別のサブエージェントに分割し、並列で分析させます。1 つのコンテキストに全部読ませると量に溺れるためです。
各サブエージェントには次を守らせています。
- 外部サイトを取りに行かない
- 担当カテゴリ以外に手を出さない
- 状態ファイルに書き込まない
- 出力は構造化テキストのみ
収集は前段で終わっているため、再取得しても時間が延びるだけです。状態ファイルへの書き込みを禁じているのは、並列で書くと壊れるためで、更新はオーケストレーターだけが行います。
各トピックについて「事実(出典 URL 付き)」「推測」「読者の得になる切り口」の 3 点を返させ、事実と推測を必ず分けさせています。
5-4. スコアリング — 何を上に出すか
最終的な並べ替えは次の式で決めています。
score = 0.35 × ジャンル関連度   (profile.yml の genre 比で重み付け)
      + 0.25 × 新規性           (初出からの経過時間 × 日本語記事の少なさ)
      + 0.20 × 具体性           (数字・固有名詞・金額があるか)
      + 0.20 × 行動可能性       (読者が明日やれるか)
      − 煽り度ペナルティ
最後の項が効きました。profile.yml に書いた「煽らない」という制約を、スコアの段階で担保する狙いです。「もう遅い」「知らないとヤバい」といった切り口はここで沈む。
そして採用・不採用にかかわらず、全候補を理由付きで JSON に記録しました。「なぜこのネタが出なかったのか」は、この記録を見れば分かる。
実際の記録には「『転職』の誤ヒット(ゲーム記事)」「同一調査の地域切り出しで、標本が小さく率として扱えない」といった判断理由が残っていました。
6. 届け方 — Flex Message と HTML レポート 📱
「LINE は Markdown を解釈しません」
LINE Notify の代替を探している方へ
この節が、個人の自動化通知向けの代替実装そのものです。要点だけ書きます。
- LINE Notify のトークン方式は終了済みで戻りません。個人の通知用途でも、移行先は LINE 公式アカウント(Messaging API)です
- 大勢に配信しないなら
broadcastではなく push message(POST https://api.line.me/v2/bot/message/push)を使います。宛先toには自分のuserId1 件だけを指定すれば足りますuserIdは、作成した公式アカウントを自分で友だち追加して 1 回メッセージを送ると、届く Webhook イベントのsource.userIdから取得できます- 個人の通知量なら、無料のコミュニケーションプラン(月 200 通)で足りることがほとんどです
- 公式アカウントの運用自体を避けたいなら、メール送信や Discord の Webhook 通知も代替になります
当初はプレーンテキストで送っていましたが、見え方が良くありませんでした。そこで Flex Message(CSS Flexbox 準拠のカード UI)に切り替えています。カルーセルに 5 件+「全文を見る」の 6 枚を並べる構成です。
なお LINE Notify は 2025 年 3 月 31 日にサービスを終了しているため、通知用途では Messaging API の push / broadcast を使う必要があります。
全文レポートは自己完結の HTML として生成し、クラウドストレージに置きました。外部リクエストを一切しない方針にしたため、ストレージから配信するだけで表示できます。
レイアウトは「読み物」ではなく「スキャンする道具」として設計しました。
- 上部に統計帯(候補数 / 採用数 / 既出で除外した数 / 情報源の生存数)
- 1 件 1 行のスキャン形式で、順位・カテゴリ色・情報源・スコアバーをメタ 1 行に凝縮
- 詳細は
<details>で畳む
デザインの方向性を決める際は「明快さを見た目より優先し、データの優先度を色で符号化する」という原則に寄せ、装飾は罫線と余白だけで構成しています。角丸のボックスを積み重ねたり、絵文字をアイコン代わりに使ったりはしていません。
7. 踏んだ落とし穴 🕳️
「同じ場所で 3 回止まりました」
最も時間を溶かしたのは、レポート生成の工程が「成功」を返しながら何も出力しないという症状でした。数分で終了し、エラーもなく、ファイルだけが存在しない。
原因はエージェントの起動方法でした。サブエージェントを既定の非同期(バックグラウンド)で起動していたため、オーケストレーターは「完了通知を待つ」状態に入ってターンを終えていたのです。cron の一発実行には次のターンが存在しないため、通知は永遠に届きません。
解決は同期実行への変更でした。同一メッセージ内で複数のツール呼び出しを出せば並列性は保たれるため、同期実行でも分割の効果は失われません(サブエージェントの仕様は公式ドキュメントに記載があります)。
この診断に時間がかかった理由は明確で、エージェント自身が何を言って終わったのかがログに出ていなかったからです。実行トランスクリプトをログへ吐き出すようにした直後、原因は 1 回の実行で判明しました。
自動化を組むときの教訓として、次の 2 点を挙げておきます。
- 「成果物ゼロで成功」を成功として扱わない。 生成物の存在を CI 側で検証し、無ければ落とす
- 失敗時に何が起きたかを残す。 ログに出ないものは、存在しないのと同じです
ほかにも、日付のタイムゾーンが実行環境(UTC)と運用(JST)でずれる問題や、シェルの printf が先頭のハイフンをオプションとして解釈して落ちる問題などがありましたが、いずれも「実際に動かして初めて分かる」種類のものでした。
8. コスト構造 💰
「重い処理は人数に依存せず、増えるのは配信だけです」
コストは 2 種類に分かれます。
- 固定費 — 収集と分析
- 変動費 — 配信
固定費は 1 日 1 回走るだけで、受信者が 1 人でも 1 万人でも変わりません。増えるのは配信だけです。
レポートは 1 日 1 本作って全員に同じものを配る構造なので、分析コストは受信者数と無関係です。この分離が、この種の仕組みの経済性を決めます。
一方で LINE の配信コストは階段状に跳ねます。料金プランによれば、無料のコミュニケーションプランは月 200 通、ライトプランは月 5,000 通です。ここで注意すべきは、無料プランとライトプランは超過分を購入できないという点です。上限に達すると配信が止まります。従量課金が可能なのはスタンダードプランだけです。
つまり「気づかないうちに上限へ達し、月末の数日が静かに欠ける」という事故が起こり得ます。対策として、配信前に残通数と友だち数を取得し、残りが不足する場合は配信せずにジョブを失敗させる仕組みを入れました。静かに止まるより、赤くして気づける方が良いという判断です。
そのほかの費用について、相対的な感覚だけ記しておきます。
クラウドストレージと CI は、いずれも無料枠の範囲に十分収まります(Google Cloud の無料枠、GitHub Actions の無料枠とも桁が違います)。
ブランド用の画像生成は 1 回きりの費用で、数十円の規模でした。ただし画像生成モデルには無料枠が存在しないため、事前の課金設定が必要です。
まとめ 🎊
- 巡回先より「取捨選択の基準」の明文化
- 重複排除は 3 階層
- 既出でも「続報」は採用
- 収集と分析は別プロセス
- サブエージェントは同期実行
- 「成果物ゼロで成功」を成功と扱わない
- 配信コストだけが受信者数に比例
基準を決めずに情報源だけ増やしても、出力は量が増えるだけです。重複排除を雑にやれば、3 日目から同じネタが並びます。
そして無人実行の環境には「通知を待つ」次のターンが存在しません。非同期でサブエージェントを起動すると、待ったまま何も出力せずに終了します。
最後にもう一度。生成物の存在を CI で検証し、失敗時のログを残してください。この 2 つだけは、数日後に原因を追う自分のために残しておいてください。
実際に何が届くのかは、Research Desk の紹介ページに置いてあります。
毎朝の配信は、こちらから友だち追加すると受け取れます。届くのは 1 日 1 通だけ、朝の 7:20。
参考リンク 🔗
実行基盤
- Claude Code GitHub Actions(公式ドキュメント) — automation mode とスケジュール実行
- サブエージェント(公式ドキュメント) — 並列実行と同時実行数の上限
- Events that trigger workflows(GitHub Docs) — schedule イベントの遅延仕様
配信
- Flex Message(LINE Developers) — カード UI の構造
- Send push message(LINE Developers) — LINE Notify 代替に使う push message API のリファレンス
- LINE Notify サービス終了のお知らせ — 2025 年 3 月 31 日終了
- LINE公式アカウント 料金プラン — 各プランの通数と超過時の扱い
インフラ・費用
- Google Cloud 無料枠 — ストレージと転送量の無料枠
- Gemini API 料金 — 画像生成モデルの単価